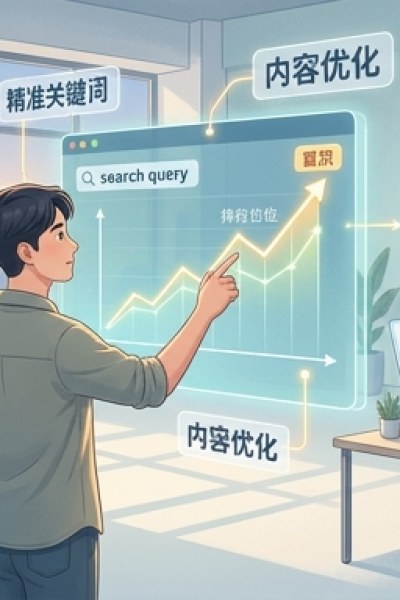
在SEO排查中,日志口径失真会直接干扰对seo优化解密页面抓取频次、状态码分布与爬虫访问深度的判断,尤其当反向代理、缓存层、WAF与应用服务的记录规则不一致时,容易把真实抓取路径切碎,导致团队误判抓取预算、错误识别低质入口,并进一步放大索引波动。要降低这类偏差,应统一日志采集字段、时间戳标准与爬虫识别规则,校正重定向链、静态资源请求与异常拦截的记录口径,再结合抓取日志、服务端日志与搜索引擎反馈交叉核验,才能更准确评估seo优化解密相关页面的收录效率与SEO优化优先级。
在SEO排查中,死链回流断档往往会让seo优化解密相关页面长期占用抓取预算,搜索引擎反复请求已失效地址,却没有及时接收到稳定的404、410或规范跳转信号,进而拖慢新页面的发现与收录效率。要减少这类问题,需要同时校验历史外链、站内旧入口、站点地图、分页参数和缓存层返回状态,确保失效URL在日志中能够形成连续、可追踪的回流闭环,并通过明确的响应策略阻断无效抓取,把有限资源重新集中到seo优化解密的有效内容上。
在SEO排查中,日志口径失真会直接干扰对seo优化解密页面抓取效率、状态码分布与抓取频次的判断,常见表现包括反向代理未透传真实来源、CDN合并记录导致访问链路缺段、统计周期不一致造成峰值错判,以及机器人请求被安全层改写后无法还原真实抓取行为;一旦基于失真的日志做优化,就可能把抓取预算、模板调整和索引诊断全部引向错误方向,因此需要统一采集规则、校准时间戳、区分渲染层与源站层记录,并持续比对搜索引擎反馈与服务器原始日志,才能更准确识别seo优化解密相关页面在SEO中的实际抓取问题。